Grafana 仪表盘
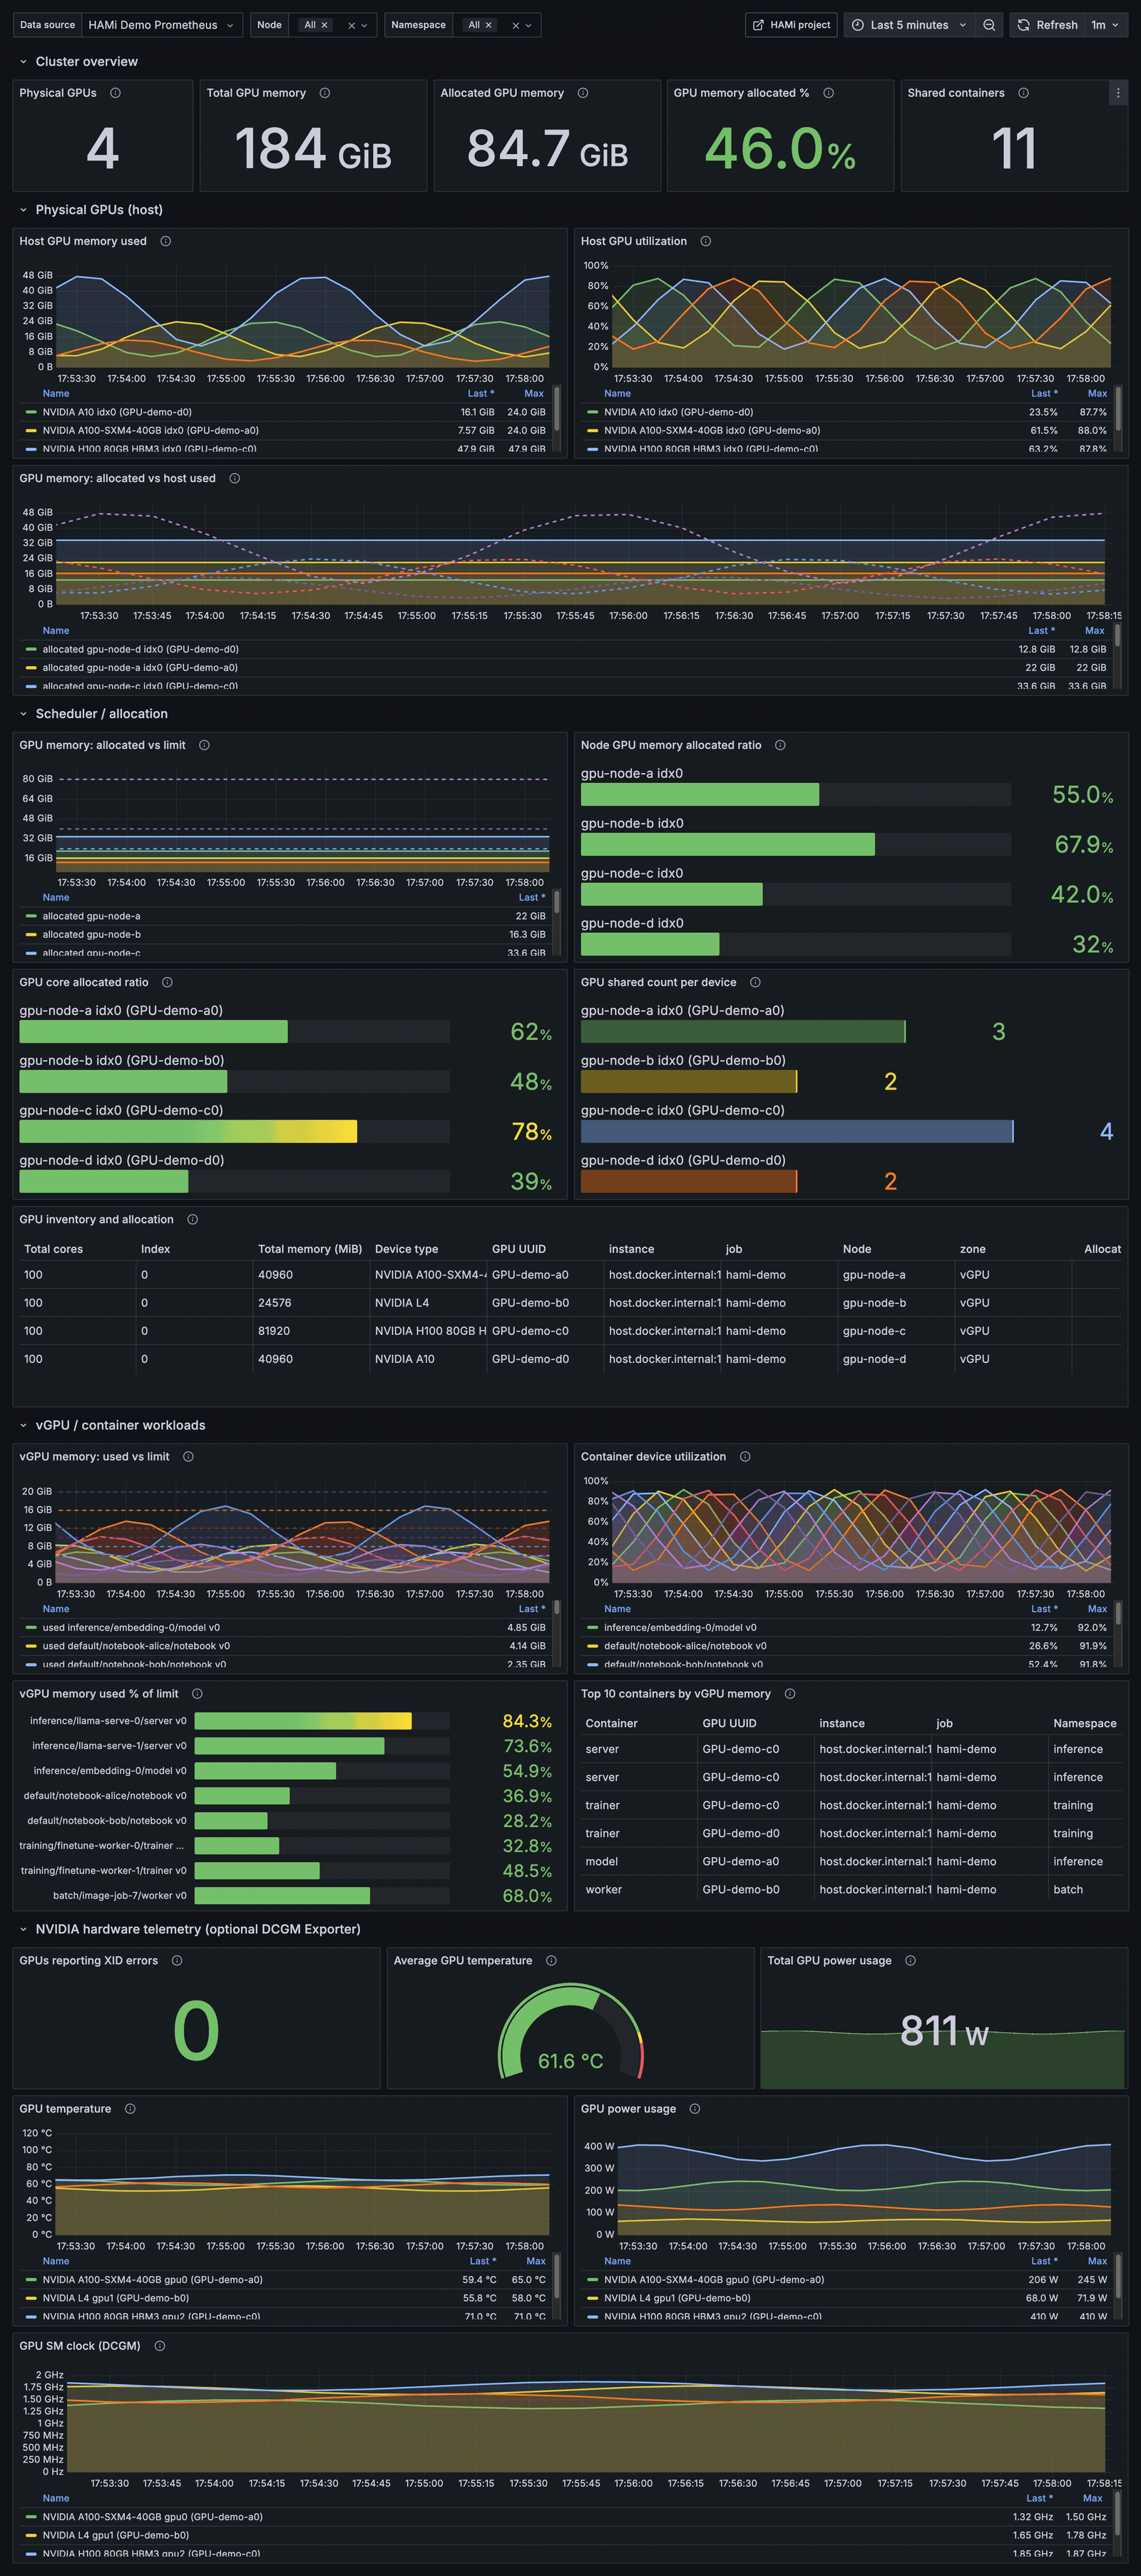
HAMi 提供 Grafana Dashboard,用于展示集群 GPU 容量、资源分配、物理 GPU 使用情况和容器 vGPU 用量。NVIDIA GPU 的硬件指标可通过 DCGM Exporter 接入。
兼容性
| 组件 | 要求 |
|---|---|
| HAMi | v2.10.0 及以上版本 |
| Grafana | 9.x 及以上版本 |
| Prometheus | 同时采集 scheduler 和 vGPU monitor 指标端点 |
| DCGM | 可选,仅 NVIDIA 硬件遥测区域需要 |
配置 Prometheus
Dashboard 从两个 HAMi 组件读取指标:
| 组件 | v2.10.0 默认 NodePort | 指标 |
|---|---|---|
hami-scheduler | 31993 | 容量、分配、共享情况和设备清单 |
| 各节点上的 vGPU monitor | 31992 | 物理 GPU 和每个容器的 vGPU 实时用量 |
HAMi v2.10.0 默认将两个监控 Service 配置为 NodePort。检查 scheduler 和 vGPU monitor 端点是否可访问:
curl http://<kubernetes-node-ip>:31993/metrics
curl http://<kubernetes-node-ip>:31992/metrics
Prometheus Operator
集群已安装 Prometheus Operator 时,启用 HAMi Helm Chart 自带的 ServiceMonitor:
helm upgrade --install hami hami-charts/hami \
  --namespace kube-system \
  --set prometheus.enabled=true
Chart 会分别为 hami-scheduler 和 vGPU monitor 创建 ServiceMonitor。Helm 渲染 Chart 前,集群中必须存在 monitoring.coreos.com/v1/ServiceMonitor CRD。vGPU monitor 的 ServiceMonitor 还要求 devicePlugin.enabled 处于开启状态。
确认 Prometheus 的 serviceMonitorSelector 和 namespace selector 能够匹配两个资源。prometheus.enabled=true 只创建 ServiceMonitor,不会安装 Prometheus 或 Prometheus Operator。
不使用 Prometheus Operator
使用 Kubernetes 服务发现采集所有 HAMi endpoint。以下示例假设 HAMi 安装在 kube-system。如果设置了 namespaceOverride,需要修改对应的 namespace。
scrape_configs:
  - job_name: hami
    kubernetes_sd_configs:
      - role: endpoints
        namespaces:
          names:
            - kube-system
    relabel_configs:
      - source_labels:
          - __meta_kubernetes_service_label_app_kubernetes_io_component
        regex: hami-(scheduler|device-plugin)
        action: keep
      - source_labels:
          - __meta_kubernetes_endpoint_port_name
        regex: monitor(port)?
        action: keep
Prometheus 需要具备通过 Kubernetes API 发现 Service 和 Endpoint 的 RBAC 权限。
导入 Dashboard
- 下载 gpu-dashboard.json。
- 在 Grafana 中进入 Dashboards > New > Import。
- 上传 JSON 文件。
- 选择包含 HAMi 指标的 Prometheus 数据源,然后点击 Import。
通过 Grafana API 导入:
curl -sS -X POST "${GRAFANA_URL}/api/dashboards/db" \
  -H "Authorization: Bearer ${GRAFANA_TOKEN}" \
  -H "Content-Type: application/json" \
  -d "{\"dashboard\": $(cat gpu-dashboard.json), \"overwrite\": true}"
JSON 使用数据源变量,不绑定固定的 Prometheus UID。导入后选择对应的 Prometheus 数据源即可。
Dashboard 变量
| 变量 | 说明 |
|---|---|
| Data source | Prometheus 数据源 |
| Node | 筛选物理 GPU 和调度面板,支持多选 |
| Namespace | 筛选 vGPU 工作负载面板,支持多选 |
Dashboard 区域
| 区域 | 面板 |
|---|---|
| Cluster overview | 物理 GPU 数量、总显存、已分配显存和共享容器数 |
| Physical GPUs (host) | 实时显存和利用率,以及分配量与实际用量的对比 |
| Scheduler / allocation | 设备上限、分配比例、共享情况和 GPU 清单 |
| vGPU / container workloads | 每个容器的 vGPU 显存、上限和利用率 |
| NVIDIA hardware telemetry (optional DCGM Exporter) | XID 错误、温度、功耗和 SM 时钟频率 |
DCGM Exporter(可选)
NVIDIA 硬件遥测区域需要以下 DCGM Exporter 指标:
DCGM_FI_DEV_XID_ERRORSDCGM_FI_DEV_GPU_TEMPDCGM_FI_DEV_POWER_USAGEDCGM_FI_DEV_SM_CLOCK
查询使用 DCGM 的 UUID 标签匹配 HAMi 的 device_uuid 标签。
故障排查
| 现象 | 检查项 |
|---|---|
| 集群概览或 GPU 清单为空 | hami-scheduler 的 31993 采集目标 |
| 物理 GPU 面板为空 | 是否发现全部 vGPU monitor Service endpoint |
| 容器面板为空 | 是否有 vGPU 工作负载正在运行,以及 Namespace 是否正确 |
| Node 或 Namespace 无选项 | 当前 Prometheus 数据源中是否包含对应标签 |
| 硬件遥测区域为空 | 是否采集 DCGM Exporter,且指标中是否包含 UUID 标签 |
