调度策略
摘要
当前在一个拥有许多 GPU 节点的集群中,节点在做调度决策时没有进行 binpack 或 spread,使用 vGPU 时 GPU 卡也没有进行 binpack 或 spread。
提案
我们在配置中添加 node-scheduler-policy 和 gpu-scheduler-policy,然后调度器可以使用此策略实现节点 binpack 或 spread 或 GPU binpack 或 spread。用户可以设置 Pod 注释来更改此默认策略,使用 hami.io/node-scheduler-policy 和 hami.io/gpu-scheduler-policy 来覆盖调度器配置。
用户故事
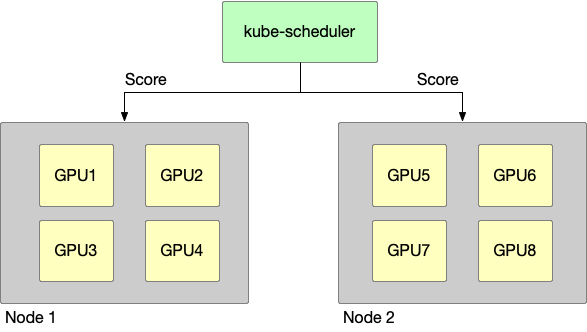
这是一个 GPU 集群,拥有两个节点,以下故事以此集群为前提。
故事 1
节点 binpack,尽可能使用一个节点的 GPU 卡,例如:
-
集群资源:
- 节点 1:GPU 拥有 4 个 GPU 设备
- 节点 2:GPU 拥有 4 个 GPU 设备
-
请求:
- pod1:使用 1 个 GPU
- pod2:使用 1 个 GPU
-
调度结果:
- pod1:调度到节点 1
- pod2:调度到节点 1
故事 2
节点 spread,尽可能使用来自不同节点的 GPU 卡,例如:
-
集群资源:
- 节点 1:GPU 拥有 4 个 GPU 设备
- 节点 2:GPU 拥有 4 个 GPU 设备
-
请求:
- pod1:使用 1 个 GPU
- pod2:使用 1 个 GPU
-
调度结果:
- pod1:调度到节点 1
- pod2:调度到节点 2
故事 3
GPU binpack,尽可能使用同一个 GPU 卡,例如:
-
集群资源:
- 节点 1:GPU 拥有 4 个 GPU 设备,它们是 GPU1, GPU2, GPU3, GPU4
-
请求:
- pod1:使用 1 个 GPU,gpucore 是 20%,gpumem-percentage 是 20%
- pod2:使用 1 个 GPU,gpucore 是 20%,gpumem-percentage 是 20%
-
调度结果:
- pod1:调度到节点 1,选择 GPU1 这个设备
- pod2:调度到节点 1,选择 GPU1 这个设备
故事 4
GPU spread,尽可能使用不同的 GPU 卡,例如:
-
集群资源:
- 节点 1:GPU 拥有 4 个 GPU 设备,它们是 GPU1, GPU2, GPU3, GPU4
-
请求:
- pod1:使用 1 个 GPU,gpucore 是 20%,gpumem-percentage 是 20%
- pod2:使用 1 个 GPU,gpucore 是 20%,gpumem-percentage 是 20%
-
调度结果:
- pod1:调度到节点 1,选择 GPU1 这个设备
- pod2:调度到节点 1,选择 GPU2 这个设备
设计细节
Node-scheduler-policy
Binpack
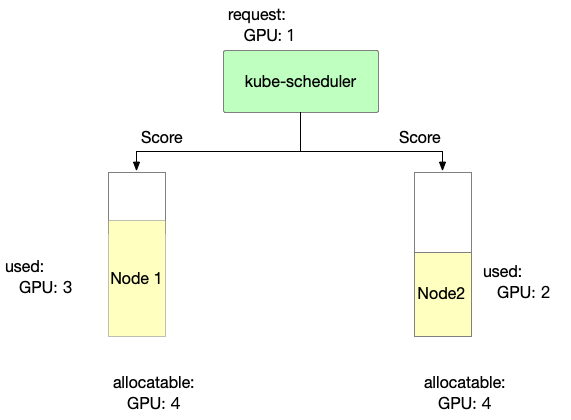
Binpack 主要考虑节点资源使用情况。使用越满,得分越高。
score: ((request + used) / allocatable) * 10
-
节点 1 的 Binpack 评分信息如下
Node1 score: ((1+3)/4) * 10= 10 -
节点 2 的 Binpack 评分信息如下
Node2 score: ((1+2)/4) * 10= 7.5
因此,在 Binpack 策略中我们可以选择 Node1。
Spread
Spread 主要考虑节点资源使用情况。使用越少,得分越高。
score: ((request + used) / allocatable) * 10
-
节点 1 的 Spread 评分信息如下
Node1 score: ((1+3)/4) * 10= 10 -
节点 2 的 Spread 评分信息如下
Node2 score: ((1+2)/4) * 10= 7.5
因此,在 Spread 策略中我们可以选择 Node2。
GPU-scheduler-policy
每个 Pod 的设备评分权重
默认情况下,HAMi 在计算物理设备得分时,会让预测的虚拟设备槽位、设备核心和设备显存利用率具有相同的影响。若要为某个工作负载调整它们的相对影响,可为 Pod 添加 hami.io/device-scoring-weights 注解:
apiVersion: v1
kind: Pod
metadata:
  name: memory-weighted-gpu-pod
  annotations:
    hami.io/device-scoring-weights: "slot=1,core=1,memory=3"
spec:
  containers:
    - name: workload
      image: ubuntu:22.04
      command: ["bash", "-c", "sleep 86400"]
      resources:
        limits:
          nvidia.com/gpu: 1
          nvidia.com/gpumem-percentage: 40
HAMi 会预测在放置请求后每个候选设备的利用率,然后按以下公式计算设备得分:
score = 10 * (
    slotWeight * predictedSlotUtilization +
    coreWeight * predictedCoreUtilization +
    memoryWeight * predictedMemoryUtilization
)
注解必须包含 slot、core 和 memory 三个键。每个值都必须是非负整数,并且至少有一个值大于零。键的顺序以及两侧的空格不会影响解析。如果未设置该注解,HAMi 将使用 slot=1,core=1,memory=1,从而保持默认评分行为。启用准入 Webhook 后,如果请求 HAMi 管理资源的 Pod 包含无效注解,则会在创建时被拒绝。如果准入验证不可用,调度器会拒绝此次调度尝试,Pod 将保持不可调度状态,直到该注解被修正。
例如,假设一个 Pod 请求 1 个 vGPU 和 40% 的设备显存,并且在计入该请求后有两个候选 GPU:
| 设备 | 预测槽位利用率 | 预测核心利用率 | 预测显存利用率 |
|---|---|---|---|
| GPU A | 0.2 | 0.9 | 0.5 |
| GPU B | 0.8 | 0.1 | 0.6 |
使用默认的 1:1:1 权重时,GPU A 得分为 16,GPU B 得分为 15,因此 binpack 会优先选择 GPU A。使用 slot=1,core=1,memory=3 时,GPU A 得分为 26,GPU B 得分为 27,因此 binpack 会优先选择 GPU B。在 spread 策略下,则会优先选择得分较低的设备。
该注解只会改变用于排序候选设备的利用率得分。它不会绕过设备适配或容量检查、mutex 规则、NUMA 或拓扑约束,也不会改变厂商特定的 Fit 行为。这些约束仍保留现有的优先级;当拓扑候选项在其他方面相同时,可以使用利用率得分顺序作为决胜条件。
Binpack
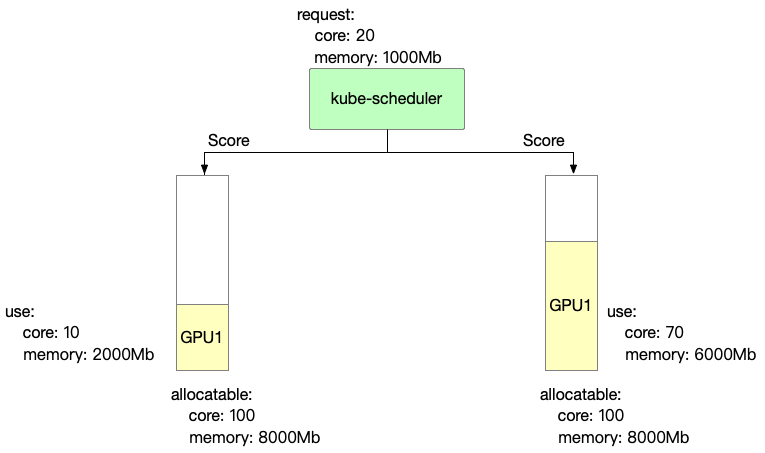
Binpack 优先选择设备利用率得分较高的卡。以下默认权重示例假设每张卡有 10 个虚拟设备槽位,并且当前恰好有 1 个槽位正在使用:
score: ((request.slot + used.slot) / allocatable.slot +
        (request.core + used.core) / allocatable.core +
        (request.mem + used.mem) / allocatable.mem) * 10
-
GPU1 的 Binpack 评分信息如下
GPU1 Score: ((1+1)/10 + (20+10)/100 + (1000+2000)/8000) * 10 = 8.75 -
GPU2 的 Binpack 评分信息如下
GPU2 Score: ((1+1)/10 + (20+70)/100 + (1000+6000)/8000) * 10 = 19.75
因此,在 Binpack 策略中我们可以选择 GPU2。
Spread
Spread 优先选择设备利用率得分较低的卡。使用相同的默认权重示例:
score: ((request.slot + used.slot) / allocatable.slot +
        (request.core + used.core) / allocatable.core +
        (request.mem + used.mem) / allocatable.mem) * 10
-
GPU1 的 Spread 评分信息如下
GPU1 Score: ((1+1)/10 + (20+10)/100 + (1000+2000)/8000) * 10 = 8.75 -
GPU2 的 Spread 评分信息如下
GPU2 Score: ((1+1)/10 + (20+70)/100 + (1000+6000)/8000) * 10 = 19.75
因此,在 Spread 策略中我们可以选择 GPU1。
